

Pourquoi v1 est la surface de sous-agent par défaut
OpenCodex s’installe avec la surface de sous-agent réglée sur v1. Les pages Dashboard, Models et Subagents demandent toutes confirmation avant de passer à base ou v2 et renvoient vers cette page. La CLI ne demande rien.
La raison est précise : en v2, une tâche confiée par un modèle ChatGPT natif à un modèle routé est illisible pour ce dernier. C’est le cas de délégation le plus courant — un parent GPT qui lance un enfant Grok, Claude ou GLM — et en v2, il échoue systématiquement.
Ce que vous voyez alors
Section intitulée « Ce que vous voyez alors »La création de l’agent est rejetée au lieu de produire silencieusement une tâche enfant vide :
{ "error": { "code": "unreadable_encrypted_agent_task", "message": "Routed V2 worker task is encrypted for the native ChatGPT backend and cannot be read by the selected provider. Use plaintext V2 agent-message delivery or select a native ChatGPT model." }}Le serveur renvoie HTTP 400 sans jamais renvoyer le texte chiffré. Cet échec fermé est volontaire : transmettre une charge illisible donnerait à l’enfant une consigne vide et conduirait à une réponse erronée présentée avec assurance.
Pourquoi cela se produit
Section intitulée « Pourquoi cela se produit »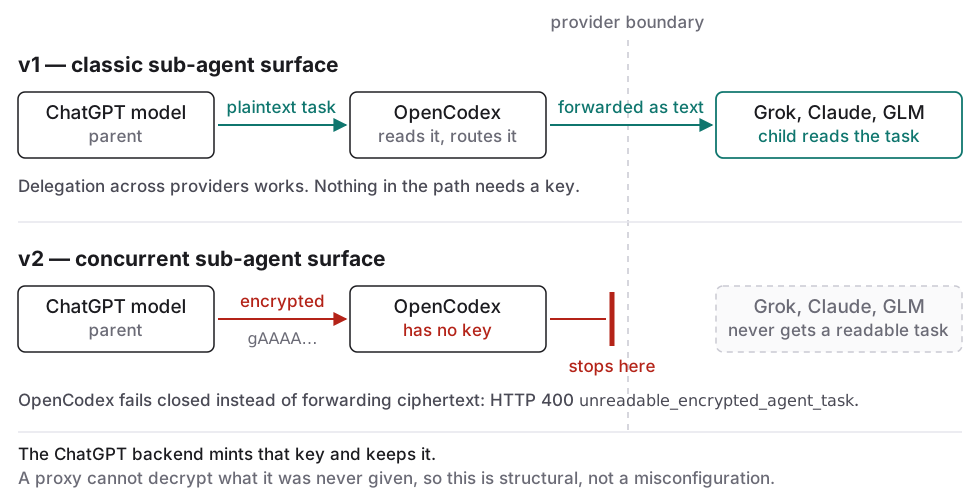
En v1, le parent émet la tâche de l’enfant en texte clair. OpenCodex la lit et l’achemine ; l’enfant routé reçoit une consigne exploitable.
En v2, le parent émet la tâche sous forme de encrypted_content, produit par
le backend ChatGPT. La clé reste dans ce backend. OpenCodex ne l’a jamais eue :
le proxy ne peut donc rien déchiffrer ni réécrire. La valeur est réellement du
texte chiffré, et non du texte clair caché derrière un indicateur. La limite
est structurelle, pas un défaut de configuration, et aucun réglage du proxy
ne peut y remédier.
Trois configurations restent possibles, ce qui éclaire la forme de l’échec :
| Topologie | v1 | v2 |
|---|---|---|
| Parent ChatGPT vers enfant routé | fonctionne | échoue par défaut ; voir le relais optionnel ci-dessous |
| Parent routé vers enfant routé | fonctionne | fonctionne |
| Parent ChatGPT vers enfant ChatGPT | fonctionne | fonctionne — le backend peut déchiffrer ce qu’il a produit |
Le backend peut toujours lire son propre texte chiffré. Seul le franchissement de la frontière échoue.
Est-ce corrigé en amont ?
Section intitulée « Est-ce corrigé en amont ? »Pas encore, du moins pas pour la partie décisive. Le projet amont a fusionné openai/codex#35845, qui ajoute la prise en charge des messages de collaboration en texte clair, mais du côté de la réception. Il traite du texte clair déjà produit ; il ne fait pas en sorte qu’un parent OpenAI le produise.
L’envoi reste un problème ouvert : #36376, reproduit sur les CLI 0.146 à 0.151 sous Windows, macOS et Linux, et #37197, qui nomme directement la pièce manquante : une règle de livraison côté envoi. Aucun des deux n’a d’engagement d’un mainteneur ni de date prévue.
OpenCodex a consigné la conséquence dans #92, fermée sans suite prévue : rien dans ce dépôt ne peut la corriger. L’issue renvoie donc aux travaux en amont, plutôt qu’à une tâche en attente ici.
Fonctionnement actuel des trois modes
Section intitulée « Fonctionnement actuel des trois modes »| Mode | Surface | Quand le choisir |
|---|---|---|
| v1 (par défaut) | Chaque modèle annonce les outils de création classiques avec espace de noms. Une création peut désigner directement un autre modèle. | Si vous déléguez entre fournisseurs. C’est le réglage livré par défaut. |
| base | Épinglages des modèles en amont : Sol et Terra utilisent v2, Luna utilise v1, les modèles non épinglés suivent le propre indicateur de Codex. | Si vous voulez la surface prévue par Codex pour chaque modèle et ne déléguez qu’au sein d’un fournisseur. |
| v2 | Chaque modèle annonce les outils concurrents sans espace de noms. | Si vous voulez le nouveau modèle de sessions concurrentes et que parent et enfant restent du même côté de la frontière. |
base figure en deuxième position, car ses épinglages placent Sol et Terra — les deux modèles depuis lesquels on délègue le plus souvent — en v2. base n’est pas un compromis pour ce problème : une création ChatGPT vers un modèle routé s’y comporte comme en v2.
Si vous avez déjà choisi base ou v2
Section intitulée « Si vous avez déjà choisi base ou v2 »Rien n’a été modifié pour vous. La mise à niveau vers une version qui livre ce réglage par défaut ne réécrit pas un paramètre existant ; le tableau de bord affiche l’avis une fois et attend votre réponse.
- Continue conserve le mode actuel et cesse de poser la question.
- Switch to v1 active v1 et cesse de poser la question.
Chaque réponse est enregistrée et l’avis ne revient pas. Si vous fermez l’avis sans répondre, il réapparaît à la prochaine ouverture du tableau de bord.
Les changements de mode s’appliquent aux nouvelles sessions Codex. Lancez
une nouvelle session après votre choix. Si un hôte App durable affiche encore
l’ancienne surface, exécutez ocx sync et redémarrez cette surface Codex.
Si vous voulez tout de même v2
Section intitulée « Si vous voulez tout de même v2 »Voici quatre possibilités, dans l’ordre où la plupart des utilisateurs devraient les essayer :
- Keep ChatGPT on v1. Dans v2, l’option
keepNativeChatGptOnV1laisse Sol et Terra sur la surface v1 pour qu’ils puissent toujours lancer Grok ou Claude, tandis que les parents routés utilisent v2. C’est la solution la plus proche d’une combinaison des deux. - Delegate within one provider. Un parent routé lançant un enfant routé transmet du texte clair en v2 et fonctionne normalement.
- Trust a direct key-auth Responses relay. Un fournisseur explicitement
marqué
allowEncryptedV2AgentTasks: truereçoit la charge opaque au lieu de l’erreur 400. Réservez ce réglage aux destinations dont vous savez qu’elles peuvent consommer cette charge. - Enable
agentTaskRecovery. Fonction expérimentale désactivée par défaut. Elle récupère via le backend ChatGPT les éléments chiffrés illisiblesNEW_TASK,MESSAGE,FOLLOWUP_TASKetFINAL_ANSWER, au prix de quota, de latence et d’une dépendance à un comportement non documenté ; la récupération combo reste limitée aux tours des enfants lancés, et les fragments de jetons découpés restent non pris en charge.
Consultez Surface des sous-agents pour le fonctionnement détaillé de chaque option et Configuration des agents pour les réglages.
Quand cette page deviendra inutile
Section intitulée « Quand cette page deviendra inutile »Lorsqu’une version en amont permettra à un parent ChatGPT natif d’émettre la tâche d’un enfant routé en texte clair, la raison de ce réglage par défaut disparaîtra. Le mode par défaut reviendra alors à base, la confirmation ne s’affichera plus et cette page relèvera de l’historique plutôt que du conseil.
Changer de mode
Section intitulée « Changer de mode »Dashboard, Models et Subagents proposent le même sélecteur v1/base/v2 et demandent tous confirmation avant base ou v2. Depuis la CLI :
ocx v2 statusocx v2 mode v1La CLI ne demande pas de confirmation. C’est le même paramètre : choisissez-le en tenant compte de ce que décrit cette page.